Receba todo domingo à noite em seu e-mail nossa newsletter com exercícios reais de análise de dados econômicos e financeiros, envolvendo muito estatística, econometria, machine learning e inteligência artificial em R e Python. Tudo o que você precisa saber para estar antenado no mundo dos dados!
Pus nove IAs para prever o IPCA. Aqui está onde elas erram.
|
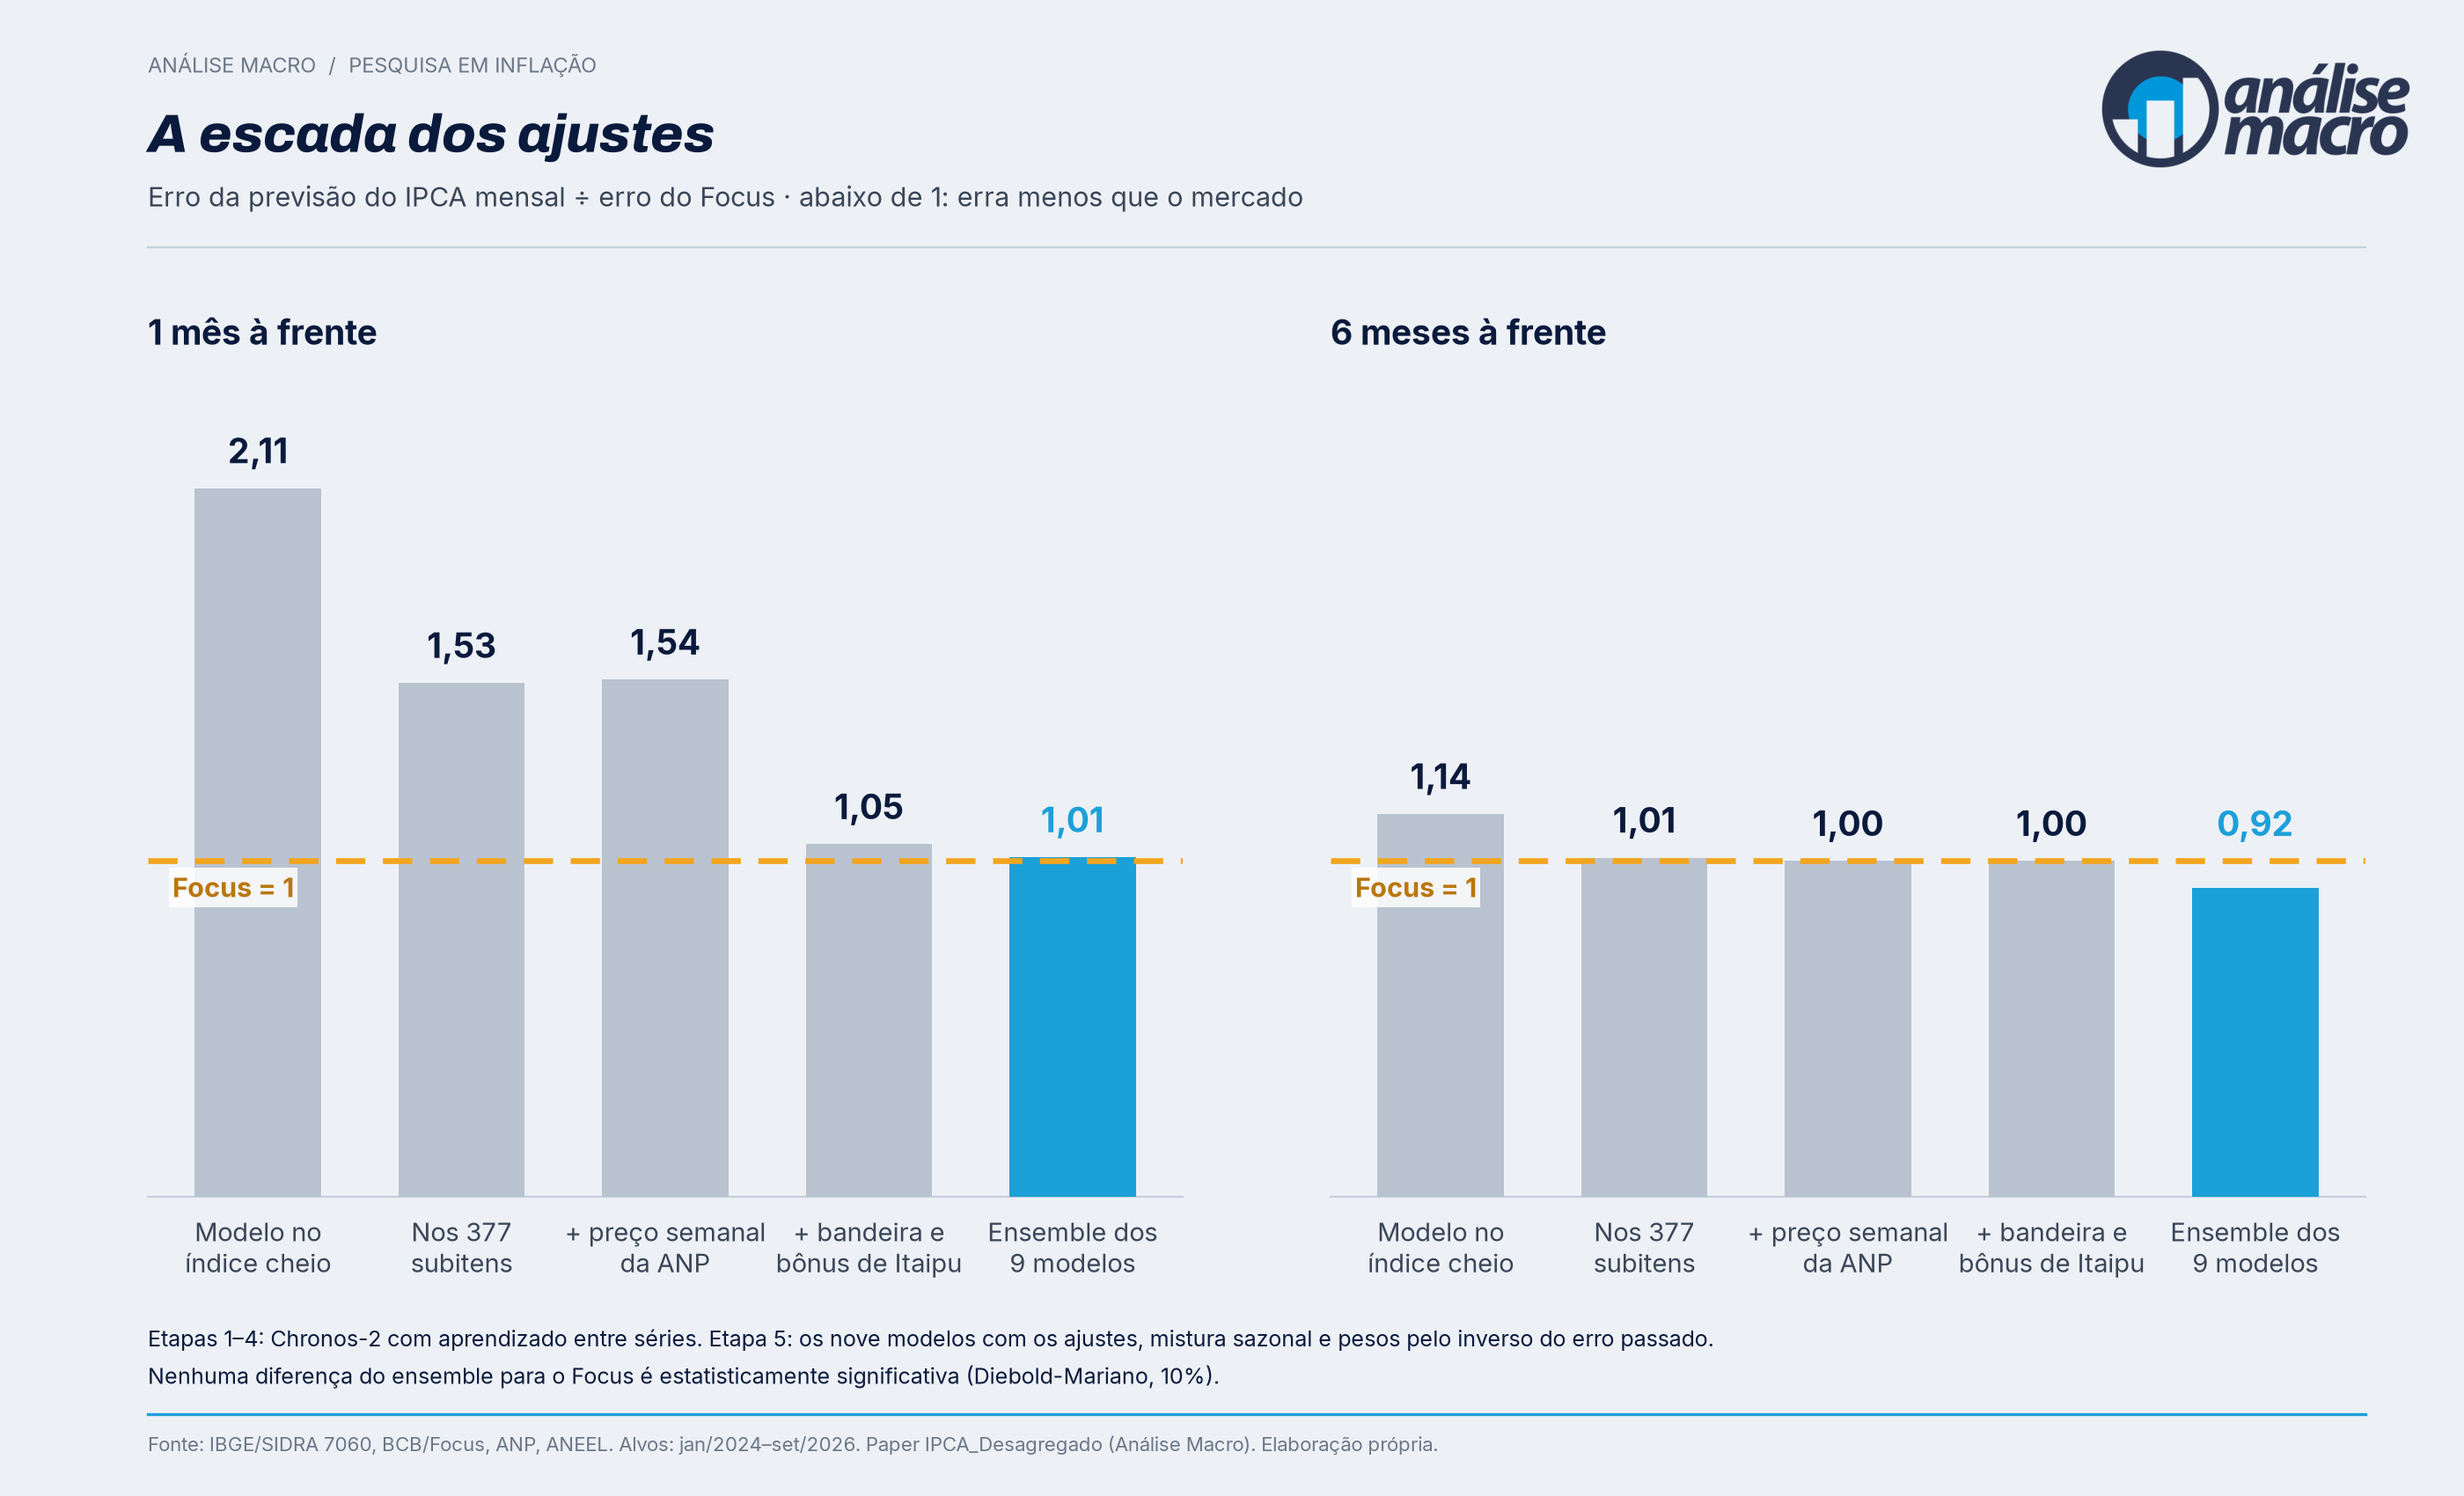
Fala, Reader, tudo bem? Na edição passada, eu contei que um projeto sobre modelos fundacionais de séries temporais estava me tirando o sono. Hoje eu mostro qual é. A pergunta era simples de enunciar e difícil de responder: modelos de IA pré-treinados em milhões de séries, usados sem nenhum treino no IPCA, conseguem prever a inflação brasileira tão bem quanto o mercado? Esta é uma edição especial, com os gráficos do trabalho. Inclusive os que mostram onde o modelo erra. 🎯 A ideia: prever o IPCA pelas peçasO IPCA não é um preço. É a soma ponderada de 377 subitens: gasolina, energia elétrica, batata, passagem aérea, plano de saúde... A ideia antiga é prever cada peça e somar com os pesos do IBGE. O problema sempre foi o custo: estimar 377 modelos, um por série, multiplica o erro de estimação. Na prática, desagregar costumava decepcionar. Os modelos de fundação mudam essa conta. Um único modelo, treinado em milhões de séries, prevê cada subitem sem estimar nada. É zero-shot: você entrega o histórico, ele devolve a previsão. Testei nove configurações, de sete organizações diferentes: Chronos-2 (Amazon, em duas versões), TimesFM 2.5 e 3.0 (Google), TiRex (NX-AI), Moirai 2.0 (Salesforce), Toto (Datadog), Granite TTM (IBM) e TimeGPT-1 (Nixtla). 🪜 A escada dos ajustesO gráfico abaixo resume o percurso. Cada barra é o erro da previsão dividido pelo erro do Focus. Abaixo de 1, erra menos que o mercado.
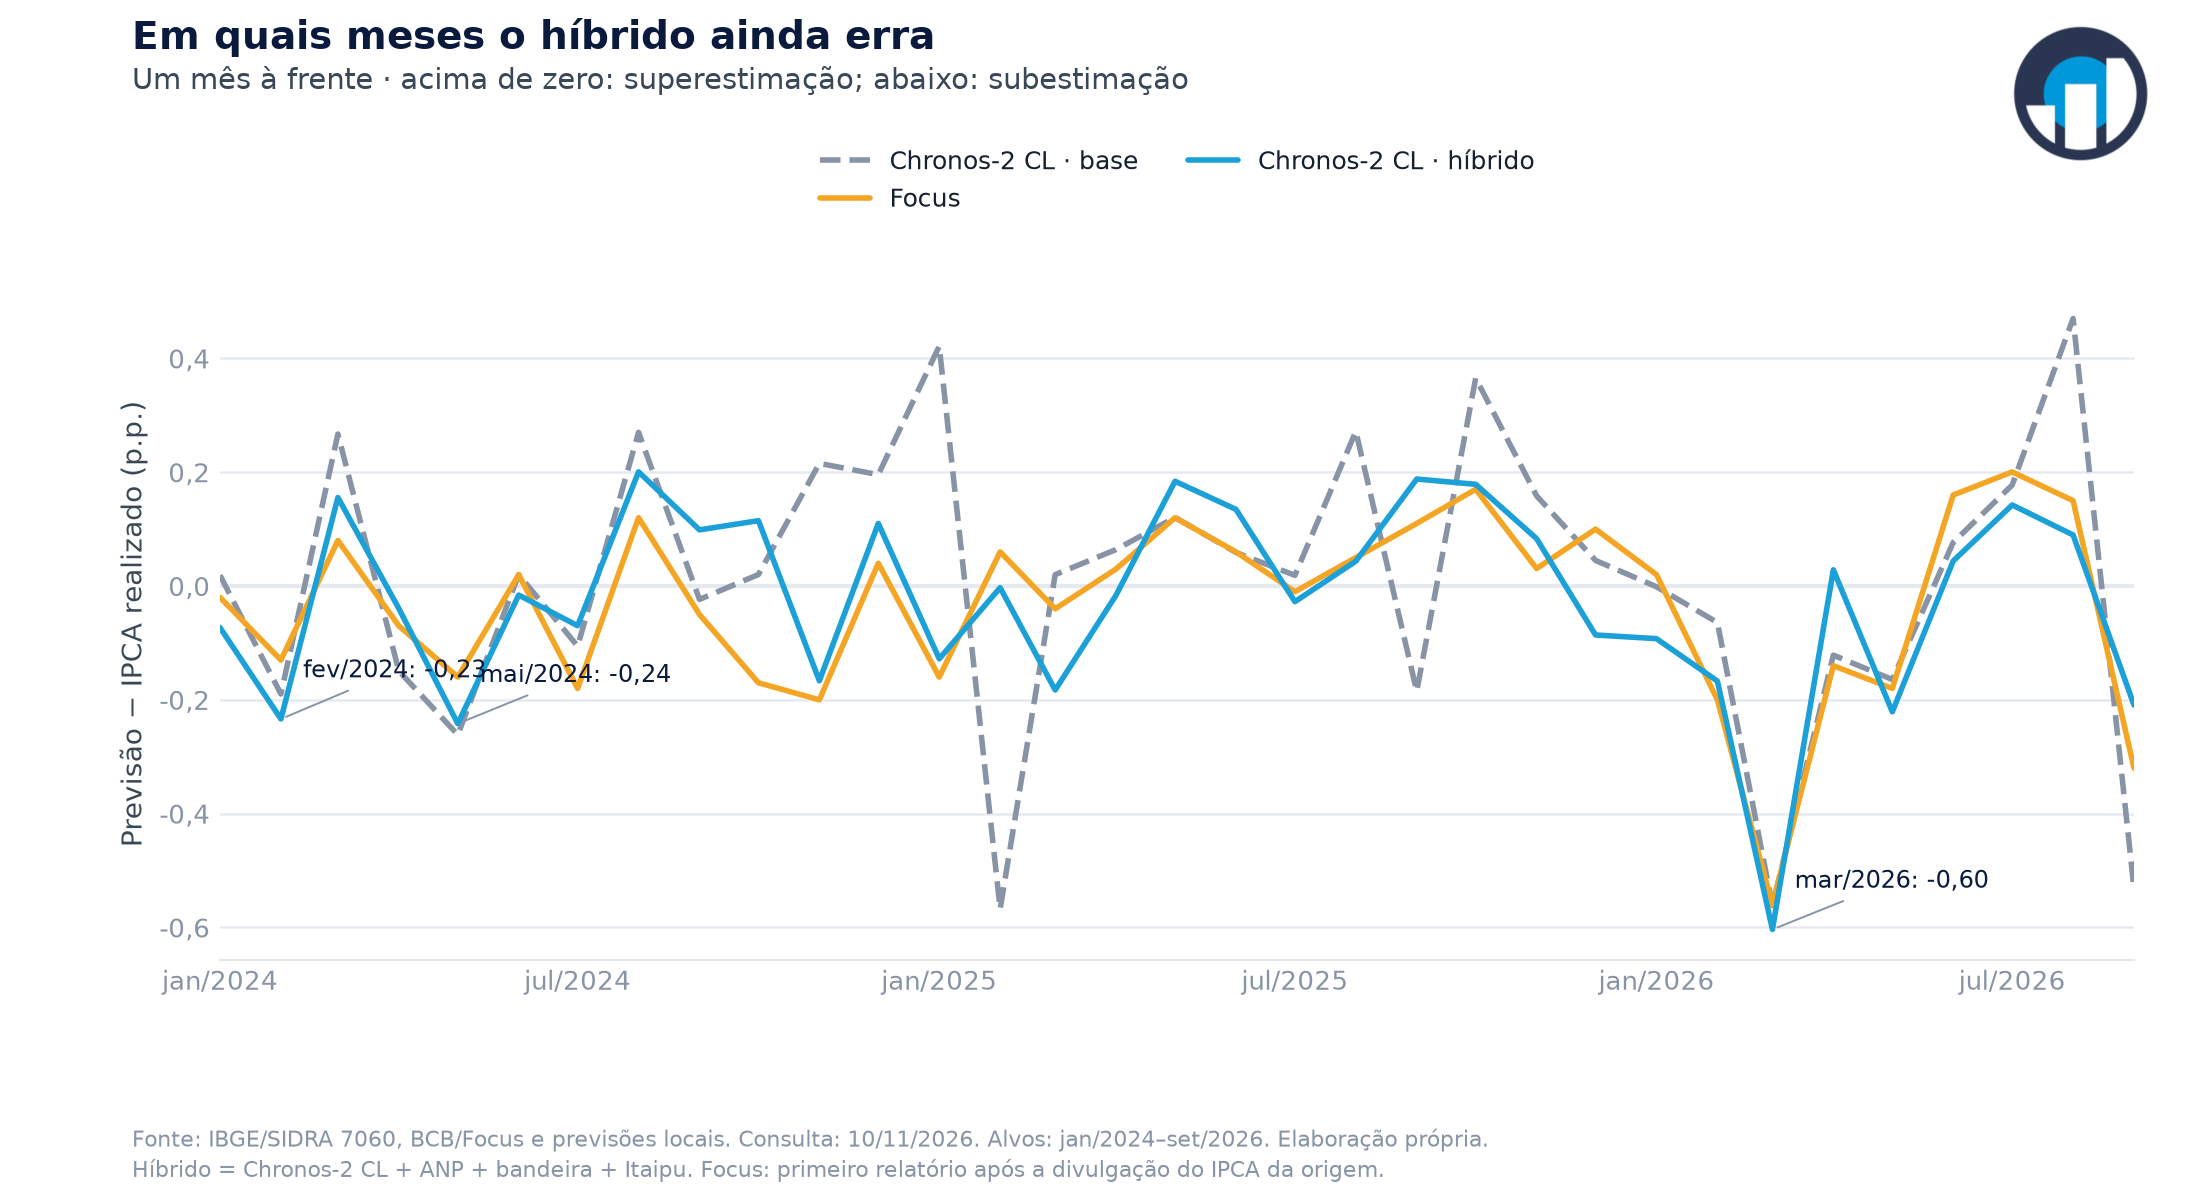
1. O modelo puro, no índice cheio: no mês seguinte, errou 2,11 vezes o que o Focus errou. Uma surra. 2. O mesmo modelo, nos 377 subitens: o erro caiu para 1,53. Desagregar reduziu o erro do mês seguinte entre 17% e 23% nos sete modelos de uso geral. É o primeiro achado do trabalho: com modelo de fundação, prever pelas peças compensa. 3. Onde estava o erro? Decompus o erro subitem por subitem. Os preços administrados respondiam por 75% do erro do mês seguinte. Só a energia elétrica, por 58%. Faz sentido. São preços decididos por regra ou por autoridade. O mercado sabe antes. Nenhum modelo estatístico, por melhor que seja, adivinha uma decisão da ANEEL. 4. Trazer a informação que o mercado tem: o preço semanal da ANP para os combustíveis quase não mexeu (1,54), porque na data da divulgação do IPCA ela cobre só parte do mês seguinte. Já a bandeira tarifária do mês seguinte, que a ANEEL anuncia antes, e os créditos do bônus de Itaipu, usados só depois de anunciados, levaram o erro para 1,05. 5. Combinar os nove: mistura com a média sazonal e pesos pelo inverso do erro passado. O ensemble chegou a 1,01 no mês seguinte e a 0,92 seis meses à frente. Ou seja: empate com o Focus no curtíssimo prazo e erro até 8% menor de 2 a 12 meses. Nenhuma dessas diferenças é estatisticamente significativa. A amostra é curta (33 meses), e eu não vou vender empate como vitória. O efeito dos ajustes fica claro mês a mês. A linha tracejada é o modelo puro; a azul, o modelo com os ajustes; a laranja, o Focus:
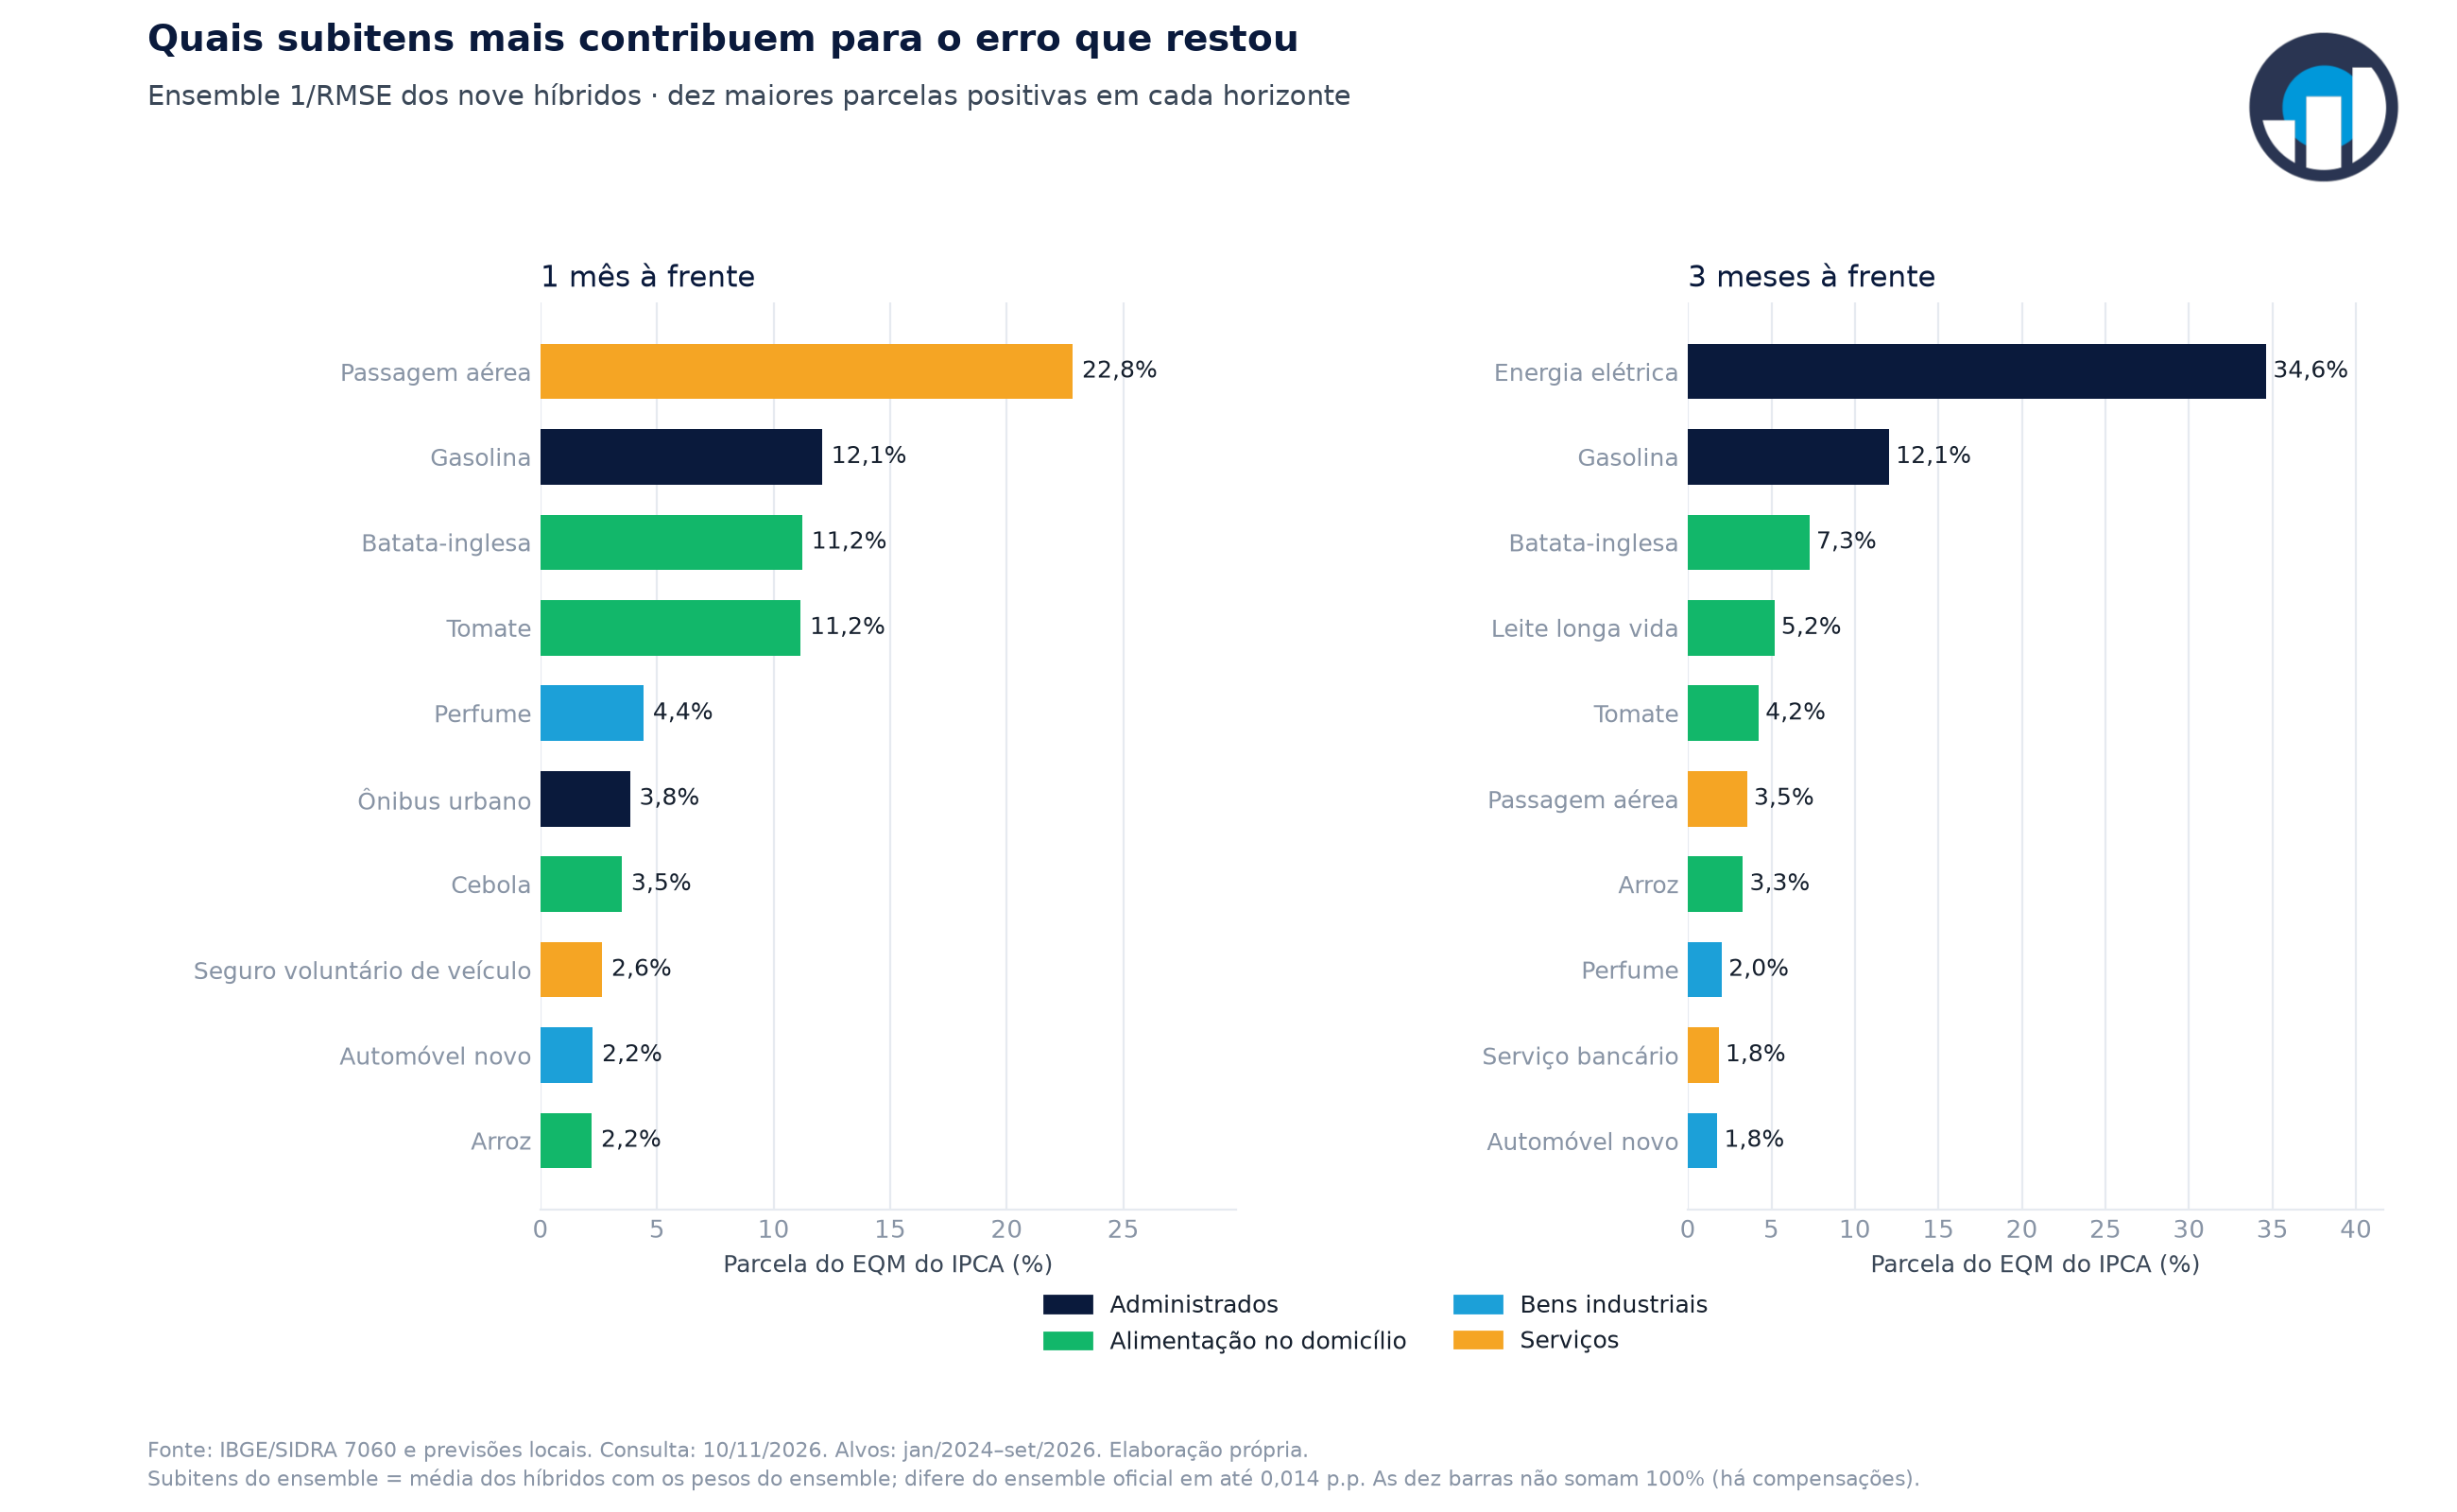
Os picos do modelo puro em jan/2025 e fev/2025 são o bônus de Itaipu: a conta de luz caiu 14,2% num mês e subiu 16,8% no seguinte. O modelo não tinha como saber. Com o anúncio da ANEEL no modelo, esses picos somem. 🔍 Onde o modelo ainda erraCom todos os ajustes, o erro que sobra mora em poucos preços:
E o teste de verdade, fora do backtest, já aconteceu. Em 10/11, com o IPCA de setembro, o ensemble previu 0,31% para outubro. O Focus da mesma semana dizia 0,33%. Veio 0,14%. Os nove modelos erraram para cima. O culpado foi um subitem só: passagem aérea, prevista em +6,0% e realizada em −9,2%. Sozinha, ela explica cerca de 0,12 dos 0,17 ponto de erro. Ainda assim, o erro do ensemble (0,17 p.p.) ficou abaixo do erro do Focus (0,19 p.p.). Um mês não prova nada. Mas a previsão agora é registrada antes de cada IPCA, num arquivo que só recebe acréscimos. É esse registro que vai dizer se o desempenho do backtest se sustenta. 🧪 O ajuste que eu desfizOs modelos superestimaram a inflação em 2024–2026. A tentação óbvia: descontar o viés médio passado da previsão. Cheguei a adotar. Depois fiz o teste honesto: em cada data, estimar o viés só com os erros já conhecidos naquele momento. Resultado: a correção piorou a previsão. No IPCA em 12 meses, o erro absoluto médio subiu de 0,48 para 0,71 ponto, e o intervalo de 80% passou a acertar só 67% das vezes (sem a correção, 79%). O viés passado não previu o viés seguinte. Revertido. A previsão publicada é a sem correção. 📈 O que os modelos dizem agora
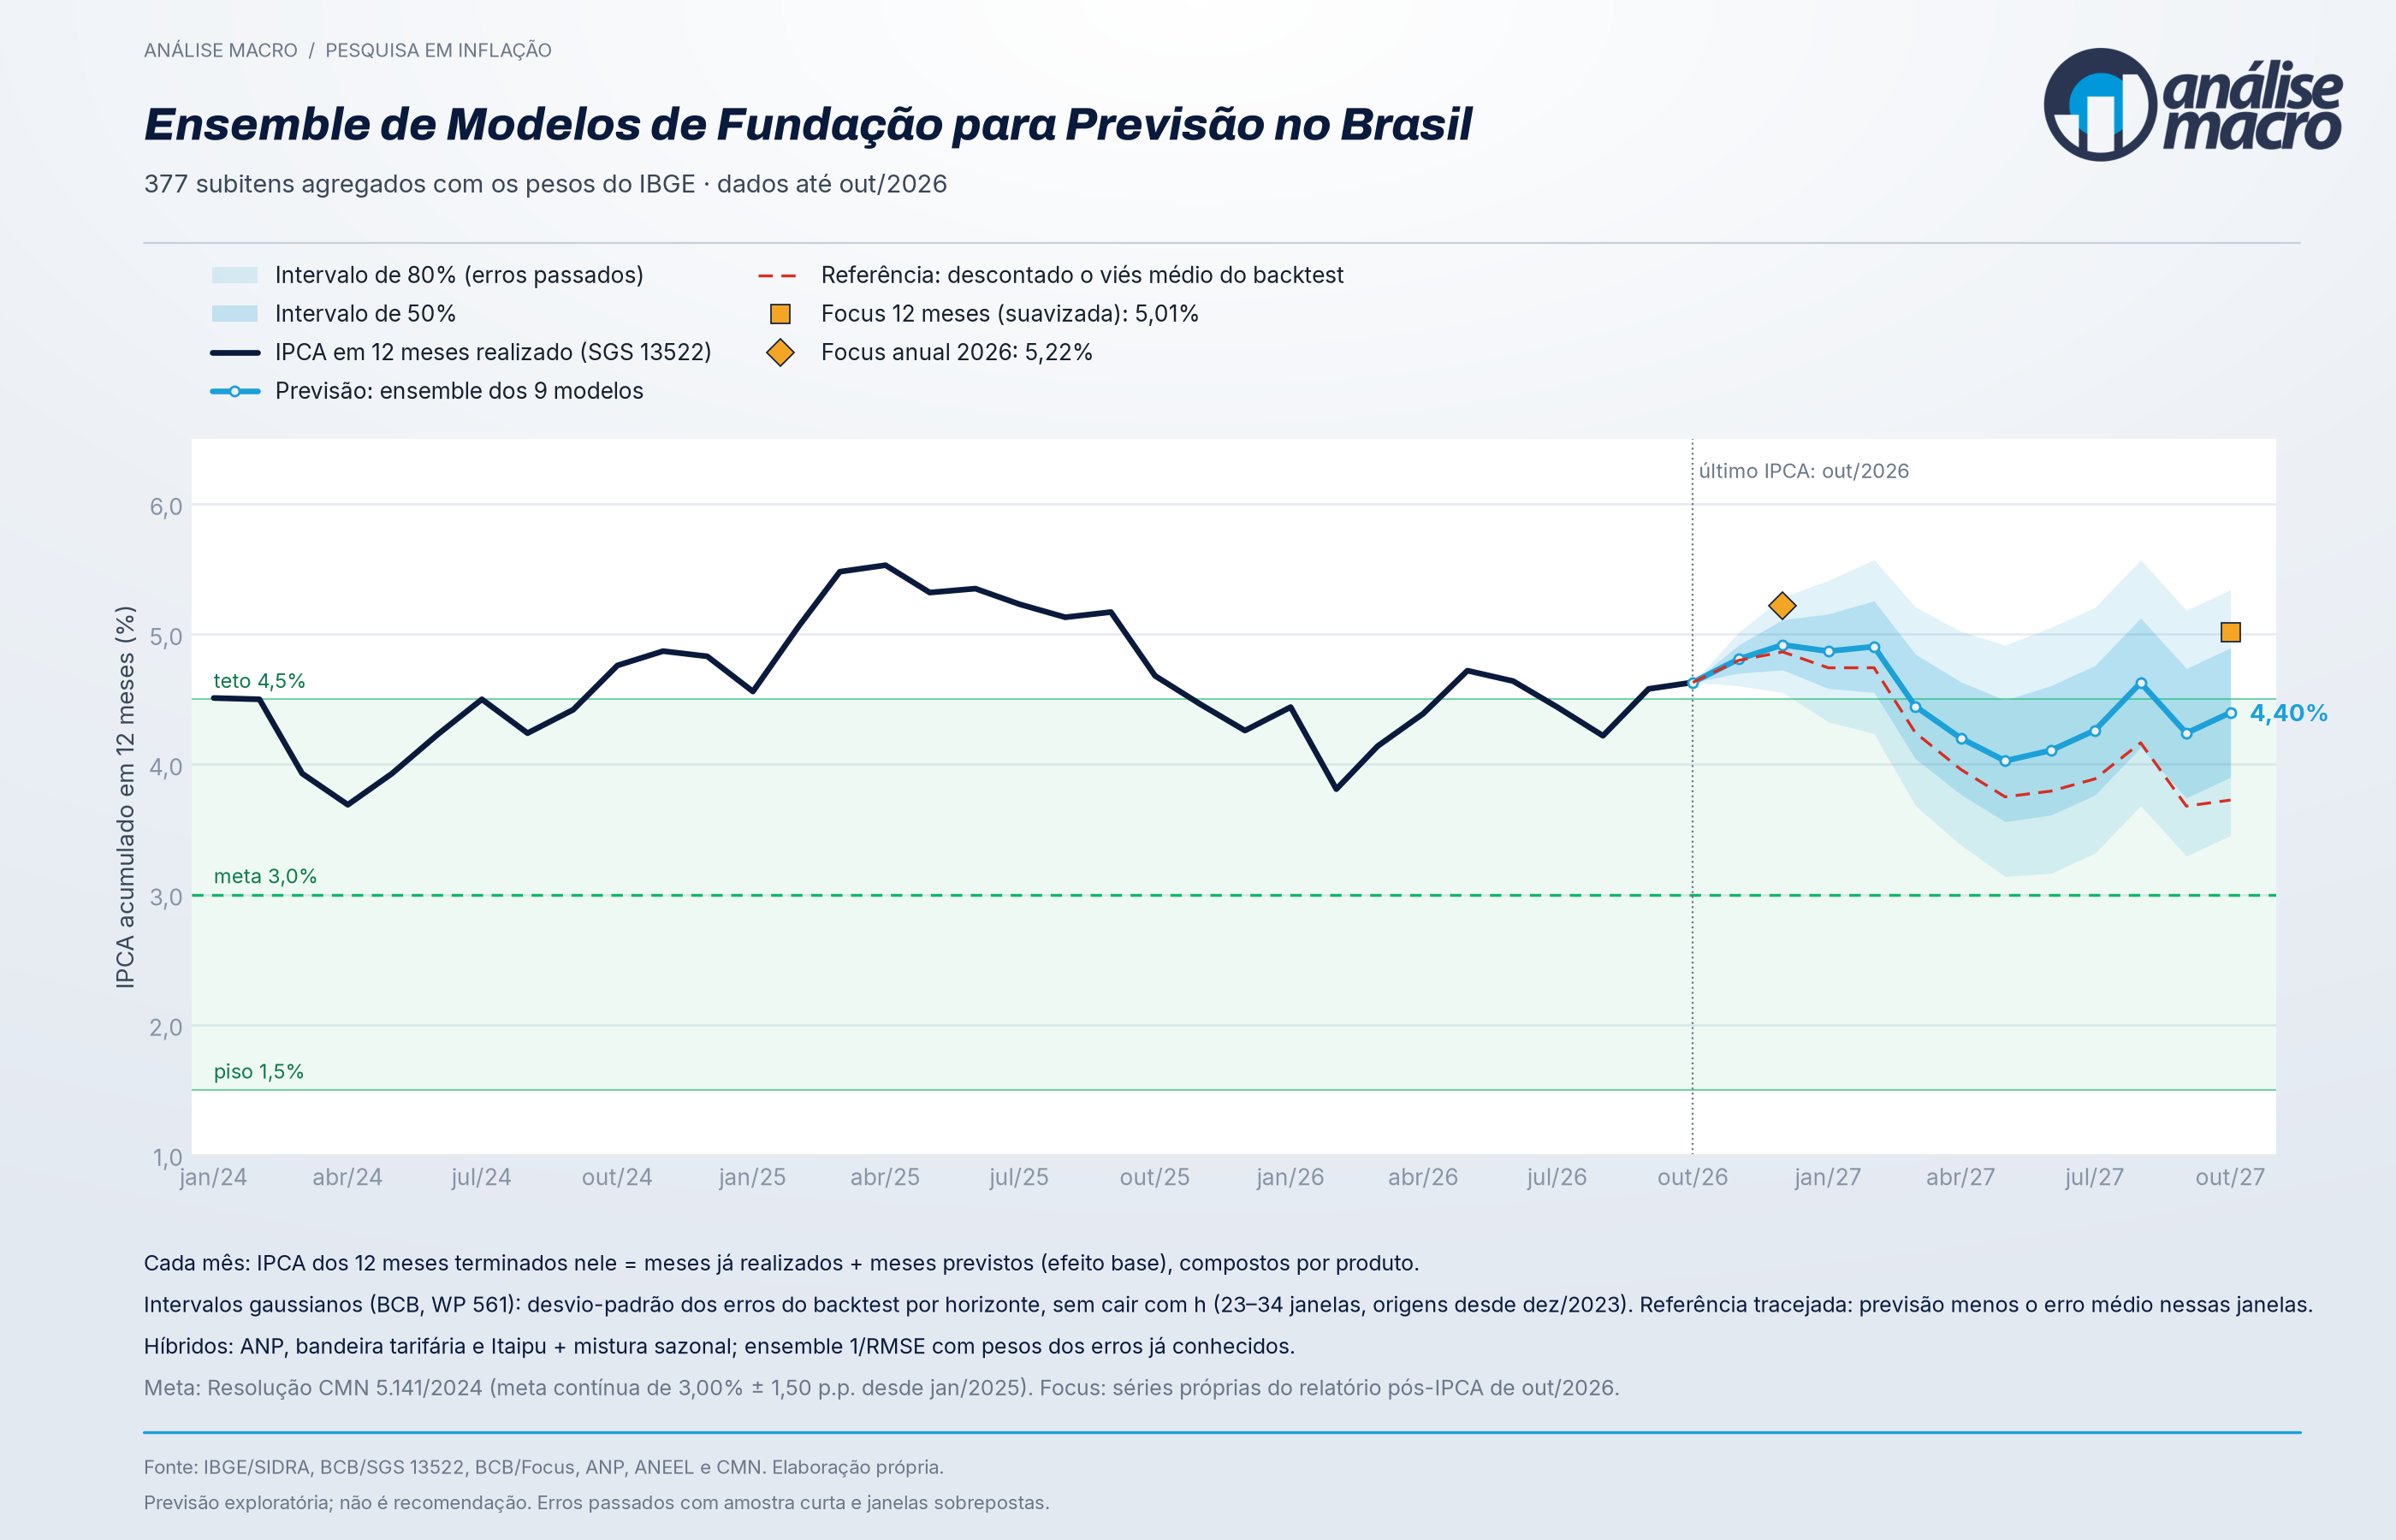
Dados até out/2026; Focus de 06/11/2026. Previsão exploratória, não é recomendação. O dashboard é atualizado a cada IPCA e tem a trajetória, a incerteza e o histórico das previsões. O paper conta o percurso inteiro, com os nove modelos, os testes e as limitações: 🧠 Insight finalO modelo de fundação entregou a parte estatística quase de graça: 377 previsões sem estimar um único parâmetro, e um ganho real ao desagregar. Mas quem fechou a distância para o mercado não foi a IA. Foi saber como cada preço é decidido: que a ANEEL anuncia a bandeira antes, que Itaipu devolve crédito na conta de luz, quando a ANP publica o preço da semana. Isso é trabalho de economista. A IA faz o pesado; o julgamento continua com quem conhece a engrenagem. DO SEU TEMA · MACROECONOMIA E MERCADO FINANCEIRO 🏛️ O que a previsão diz para a meta, e onde ela diverge do mercadoPara quem acompanha conjuntura, três leituras do trabalho:
Um cuidado antes de tomar partido: no IPCA do ano, o ensemble errou menos que o Focus em 2024 (0,56 contra 0,80 ponto) e mais em 2025 (1,21 contra 0,94). Dois anos são pouco para escolher um lado. Fonte: IBGE/SIDRA 7060, BCB/Focus (06/11/2026), BCB/SGS 13522. Previsão exploratória, não é recomendação. Para você, quem está mais perto da inflação de 2027: os modelos, com 4,40%, ou o mercado, com 5,01%? Responde este e-mail e me conta por quê. Um abraço, Vítor Wilher Análise Macro A verdade está nos dados. Qual tópico você tem maior interesse? Selecione abaixo:
Saber suas preferências me ajuda a direcionar o melhor conteúdo pra você :) |
Boletim AM
Receba todo domingo à noite em seu e-mail nossa newsletter com exercícios reais de análise de dados econômicos e financeiros, envolvendo muito estatística, econometria, machine learning e inteligência artificial em R e Python. Tudo o que você precisa saber para estar antenado no mundo dos dados!
EDIÇÃO #214 | NEWSLETTER SEMANAL DA ANÁLISE MACRO Um chope no Leblon Fala, Reader, como foi a semana pós-feriado? Por aqui, foi muito cansativa: começo da Black Friday e também um ritmo mais intenso nos estudos. Estou tocando um projeto sobre modelos fundacionais de séries temporais que está me tirando um pouco o sono. Mas faz parte, né? Entre um paper e outro, gosto de dar uma caminhada no fim da manhã para abrir a mente para novas ideias. Sentir aquele vento do mar me traz uma calma e uma...
EDIÇÃO #214 | NEWSLETTER SEMANAL DA ANÁLISE MACRO Um chope no Leblon Fala, Reader, como foi a semana pós-feriado? Por aqui, foi muito cansativa: começo da Black Friday e também um ritmo mais intenso nos estudos. Estou tocando um projeto sobre modelos fundacionais de séries temporais que está me tirando um pouco o sono. Mas faz parte, né? Entre um paper e outro, gosto de dar uma caminhada no fim da manhã para abrir a mente para novas ideias. Sentir aquele vento do mar me traz uma calma e uma...
EDIÇÃO #213 | NEWSLETTER SEMANAL DA ANÁLISE MACRO O que Minsky teria a dizer sobre a "Bolha da IA"? Fala, Reader, correria por ai? A semana por aqui foi bem interessante. Estou fazendo duas matérias eletivas de macro raiz: uma sobre câmbio e dívida soberana que provavelmente vai dar o que falar tanto aqui no boletim quanto lá na Análise Macro. Olhamos essa semana para as "crises cambiais" da década de 90. Como cada regime fixo dos países asiáticos foram caindo um a um. Isso me deixou pensando...